OpenAI 於 2026 年 11 月 20 日刊出客戶案例,主角是財務研究平台 Hebbia 與模型 GPT-6 Astra。案例講的不是新模型發佈,而是一條文件密集工序的形狀:由幾千份文件之中揀出支撐答案的段落,再按公司範本砌成簡報。對香港做盡職調查、合約審閱、投標文件與審計底稿的團隊,值得看的不是標題上的百分比,而是它把「每個結論都要指回原文」寫進了流程本身。
公布內容:三組數字全部來自供應商測試
案例列出四組數字:引用所需來源類型的比率領先最佳替代模型 13.6 個百分點;被引用段落與問題相關的比率 99.5%;符合簡報要求的比率 97.9%;簡報要求一項領先 14.4 個百分點。測試期為 2026 年 8 至 9 月的預覽版本,用同一批財務研究案例、同一套評分準則,準則由領域專家撰寫或按來源文件審核。
這些數字有兩個界線要講清楚。第一,它們是 Hebbia 自行設計與評分的測試結果,由 OpenAI 在客戶案例中轉述,不是獨立基準測試,也不是香港環境的測試。第二,「引用段落與問題相關」不等於「答案計得對」——一段文字確實關於客戶集中度,可以同時把金額或報告期抄錯。案例自己也提到,覆核可以具體到「把客戶集中度數字對回原表、改正報告期」,這正是人手把關仍然存在的位置。
對香港文件密集工序的實際含意
先講清楚不是甚麼:這不是一個香港可用的產品公布,也沒有本地價格、資料存放區域或繁體中文表現的資料。案例中的 Hebbia Matrix 是外部平台,透過 API 使用模型(案例列明產品為 API),香港公司要用,仍然要經過採購、資料落地、權限設定與語言測試。新聞稿沒提及的,不應當成已存在。
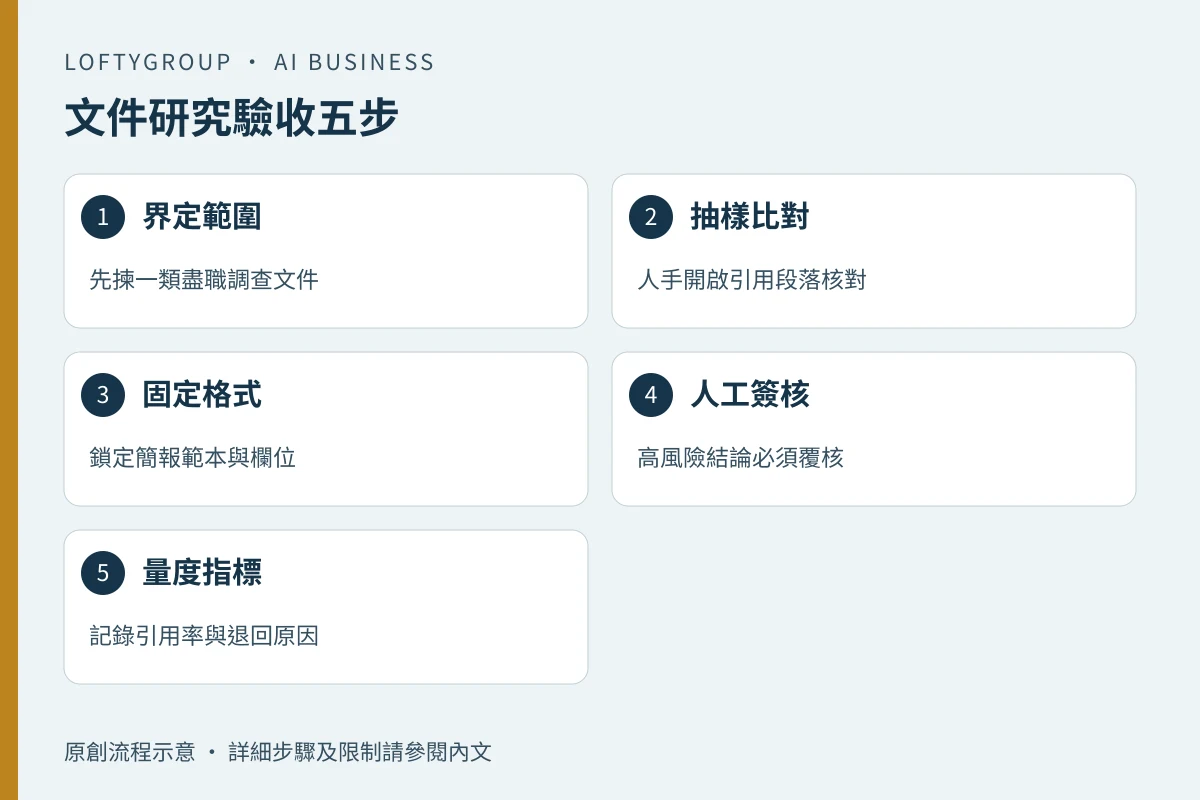
可轉移的是流程形狀,而不是某個型號。這條流程大致是:提出具體問題 → 由模型揀文件或表格格 → 每條結論附出處並可開啟原文 → 按公司範本產出初稿 → 人手抽查關鍵數字。它與單純的欄位抽取不同:AI 發票與文件入單處理的是「呢張單嘅金額喺邊」,這裡處理的是「你憑邊份文件、邊一段得出呢個結論」。兩者可以並存,但驗收方法不一樣。
同樣要分開的是內部收件匣工序。AI 電郵轉待辦的重點是分流與責任人,這裡的重點是可追溯性。若公司同時做兩件事,建議分開兩套指標,不要用一個「AI 準確率」概括。
假設例子:一份 1,800 份文件的資料室
以下完全屬假設,數字是示範用的目標,不是任何公司的實測結果。
假設一間香港貿易公司評估收購一間供應商,資料室有 1,800 份文件:客戶合約、月結報表、客戶名單、往來電郵。團隊先鎖定三個問題:收入是否集中於少數客戶、合約有無控制權變更條款、過去三年客戶流失情況。做法是把資料室接入一個支援引用的研究工具,要求每條結論旁邊列出文件與段落;再由同事抽 30 條引用逐條開啟核對,另抽 20 個關鍵數字對回原表;最後按公司簡報範本輸出初稿,交由項目主管簽核才可出去。
這個假設流程的價值不在「快」,而在「錯在哪裡可以指出來」。若引用開不到、段落對不上、或數字與原表不符,就是退回重做,而不是靠感覺判斷。
驗收指標與人手接手
| 驗收指標 | 定義 | 假設門檻(示例) |
|---|---|---|
| 引用可開啟率 | 每條結論都能跳到原文段落 | 100% |
| 引用相關率 | 抽 30 條由同事判斷是否真的支持結論 | 95% 以上 |
| 關鍵數字覆核 | 抽 20 個數字對回原表,記錄差異 | 0 宗未發現的錯 |
| 首次交付可用率 | 初稿不需重做結構的比率 | 70% 以上 |
| 退回原因分類 | 每週整理 top 3 原因 | 有紀錄可追 |
人手接手要有明確規則:涉及估值判斷、法律條款解讀、對外報價或投資委員會文件,一律由指定同事簽核;工具只出初稿與出處。任何一條引用開不到原文,該條結論即視為未成立。資料室若含個人資料,保存期、查閱權限與刪除流程要按香港個人資料私隱原則先行定義,不要等到出事才補。
落地前應向供應商問清楚的事
一,引用是平台功能還是模型輸出格式,兩者維護責任不同。二,文件與推論結果存放在哪個區域,能否設定不保留。三,有無繁體中文與中英混雜合約的測試集,測試集由誰訂。四,操作日誌保留多久,能否匯出。五,用量上限與計價方式,超額如何處理。六,離場安排:能否把引用紀錄與原檔一併匯出。
對香港中小企,最務實的起步不是追逐某個型號,而是揀一類文件、抽 30 至 50 份、定下上表五個指標,用兩星期做一次前後對照。數字好過形容詞,而「每條結論都開得返原文」通常是第一條要守住的線。