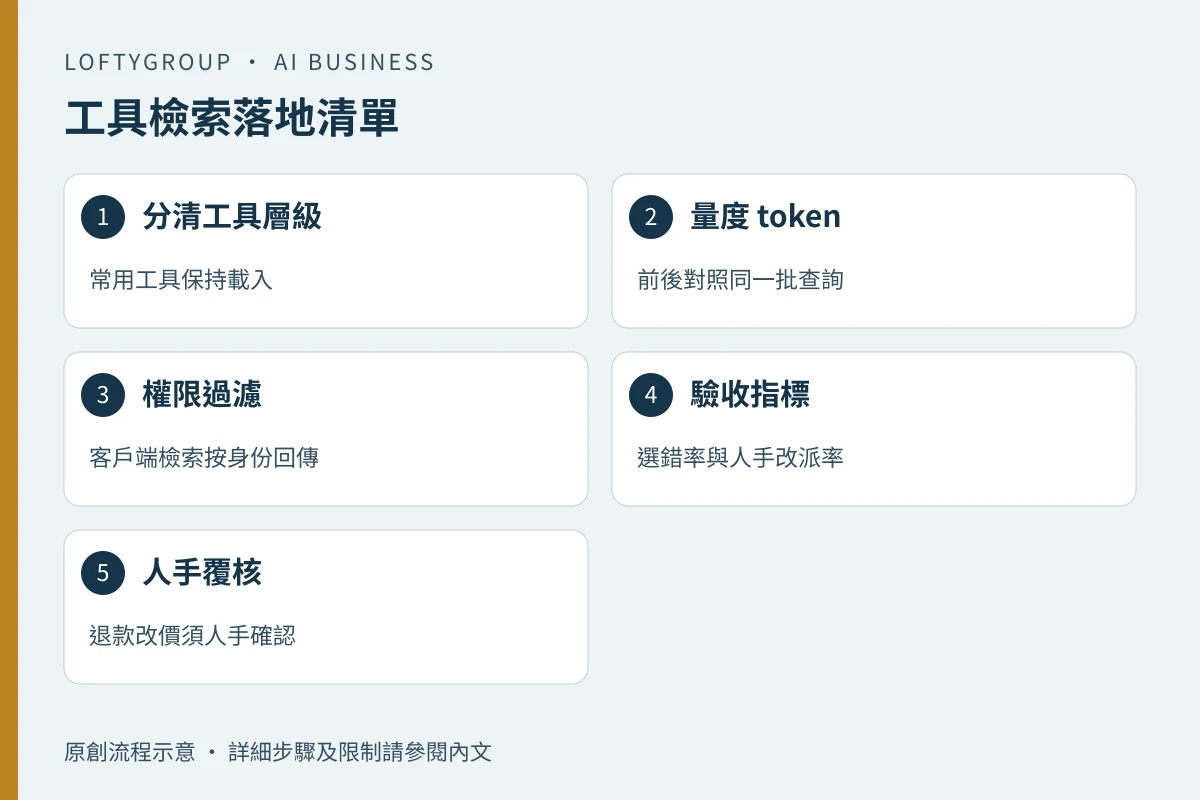
Google 於 2026 年 11 月 19 日在 Gemini API 網誌公布,Tool Retrieval 已在 Interactions API 進入預覽。對一間把 CRM 查詢、報價、審批、報表逐項包成函數的香港公司而言,這條公告真正值得看的不是「多了一個搜尋功能」,而是工具庫終於可以分層:常用工具保持載入,長尾工具按需才拉出參數 schema。
今次開的其實是「延後載入」開關
按官方說明,啟用方法是在請求中加入一個 tool_search 工具,並在指定工具上設 defer_loading: true。模型仍然看得到每個被延後工具的名稱與描述,但參數 schema 不會一開始就塞進上下文。當模型判斷需要某個工具,會在同一個請求內先要求載入該工具的完整 schema,再發出 function_call;廠方稱這三個步驟都會出現在 interaction.steps,方便排查究竟是工具命名、描述還是參數寫得有問題。
適用範圍方面,官方列出 Gemini 3.6 及之後的模型,包括所有 Gemini 4 模型。遠端 MCP server 亦支援:在 mcp_server 工具上設 defer_loading: true,該 server 暴露的整批工具便按需載入,不必逐一列出。若企業本身已有工具登記冊或按用戶身份過濾的機制,可把 tool_search 設為 execution: “client”,由自家應用執行檢索並回傳相符 schema,代價是每次搜尋多一個往返。
收費方面,廠方稱 Tool Retrieval 不另收費,按所呼叫模型的標準 token 費率計算;開啟 tool_search 會加入一小段固定輸入 token,而每次載入的 schema 會在該對話餘下部分按輸入 token 計費。以上屬廠商說法,實際省多少要按自己的流量量度,不能直接當成成本下降。
對企業工作流的實際含義
工具數量膨脹後通常出現兩個問題:每次請求都要為完整 schema 付一次 token,以及候選工具太多令模型選錯。延後載入同時針對這兩點,但企業要自己想清楚哪些工具屬於「常用」——查單、開單、回覆客戶這類高頻動作應保持載入,否則每次都要多一輪檢索,延遲會反映在同事等畫面的時間上。
更值得留意的是客戶端檢索那條路。企業若本身有權限表,可讓應用按登入者身份過濾後才回傳 schema,等於把「邊個同事可以用邊個工具」留在自家系統,而不是把所有工具描述一律交給模型。對涉及薪酬、客戶個人資料或刪除操作的函數,這種設計比單純追求 token 節省更有價值。但要清楚一點:模型在載入前仍會看到延後工具的名稱與描述,描述寫得含糊,選錯工具的問題不會因為延後載入而自動消失。
假設一間香港貿易公司把 60 個內部函數接入代理,其中 8 個是每日數十次使用的查單與開單動作,其餘 52 個是各部門的低頻查詢。把 52 個設為延後載入、8 個保持常載,是這類功能最直接的用法;但這是假設情境,實際比例要由自己的呼叫紀錄決定,不宜照抄。
限制與未確認事項
- 預覽階段,功能與參數隨時可能改動,正式生產前要預留改動成本。
- 省 token 有前提:只有從不載入的 schema 明顯多於實際載入的,才有淨節省;工具少而呼叫密的流程,可能反而多付那段固定開銷。
- 客戶端檢索多一次往返,延遲要實測,不能假設與伺服器端檢索一樣快。
- schema 一旦載入,會在該對話餘下部分持續按輸入 token 計費,長對話要特別留意。
- 香港可用性、區內資料處理安排、企業支援範圍,來源均無提及,不應假設本地已可正式使用。
落地前的驗收與人手界線
建議用一個真實但低風險的流程做兩週對照:同一批查詢,一組照舊全量載入,一組用延後載入,量度四項指標——每次請求的輸入 token、首次就選中正確工具的比率、需要人手改派的比率、端到端完成時間。驗收可以寫成:工具選錯率不高於基線、token 下降有前後對照紀錄、所有工具呼叫可在 interaction.steps 追溯。
人手界線要事先寫死。退款、改價、刪除紀錄、權限變更一類工具,即使模型正確選中,也應由人手按鈕確認才執行;工具描述由誰維護、多久檢視一次,要有具名責任人。否則工具越加越多,出錯時只會更難追。要判斷這種分層是否值得做,可先參考AI Agent 香港中小企指南與AI 系統整合實戰清單的既有流程,再決定是否把工具庫拆層。